
霄云科技发布大模型推理缓存产品:银河AstraCache
霄云科技正式发布面向大模型推理的KV Cache存储产品——银河AstraCache。产品通过共享全闪存储扩展KV Cache容量,支持多推理实例复用和跨重启保留,减少重复预填充计算,降低首token延迟与推理成本,提升整体吞吐。银河AstraCache 已完成与vLLM、SGLang和LMCache的对接。
推理缓存新需求
大模型推理需要先对输入内容进行预填充计算,生成KV Cache,再逐步生成回答。当新请求与历史请求具有相同前缀时,读取已保存的KV Cache,即可跳过对应前缀的重复计算,缩短首token延迟,并释放GPU算力以服务更多请求。
长上下文与高并发推理持续推高KV Cache容量需求。当缓存仅保存在单个实例的显存和内存中时,可保留的历史前缀有限,也难以在多个实例之间充分复用。银河AstraCache将KV Cache扩展到共享SSD存储,为长上下文、多轮交互和多副本部署提供更大的缓存空间。
产品架构
银河AstraCache采用“引擎侧调度 + 外置共享存储”的架构。vLLM原生offloading、LMCache和SGLang HiCache负责缓存分层与复用,GPU显存和CPU内存承接最热的数据。需要扩展容量、跨实例共享或跨重启保留的KV Cache,通过AstraCache用户态SDK,经RDMA或TCP网络读写共享SSD存储池,实现一次写入、多实例复用。
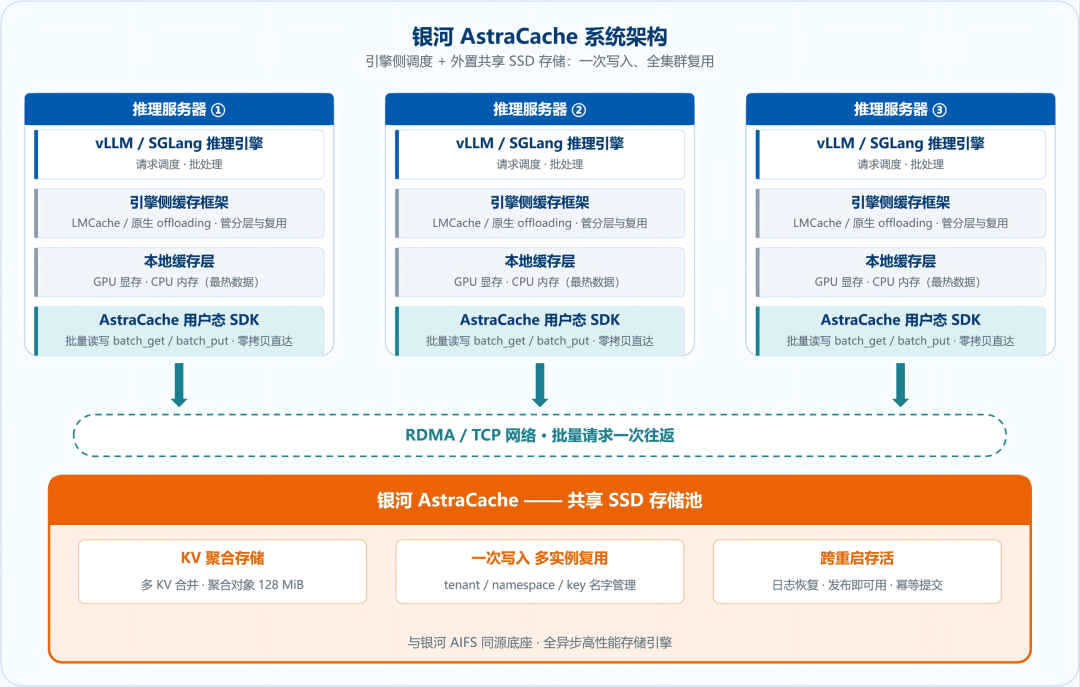
AstraCache系统架构:多台推理服务器共享SSD KV Cache存储
核心特性
一、多实例缓存共享
多个推理实例共用同一后端,相同的系统提示词和知识库前缀只需计算与写入一次,即可供全部实例复用。AstraCache采用tenant / namespace / key三层名字管理,支持名称修改,无需搬移底层数据,便于组织和管理共享缓存。
二、大容量聚合存储
面向数量庞大的KV对象,AstraCache将多个value合并写入聚合对象,以紧凑排列提高空间利用率,减少小对象存储开销。不同namespace的数据分别聚合,租户之间相互隔离。
三、高效批量访问
AstraCache通过用户态SDK直接访问存储,无需挂载文件系统,支持异步批量put、get 和lookup,以及RDMA、TCP网络通信。读写直接使用框架提供的缓冲区,减少中间数据复制;批次就绪后立即提交,不为凑批增加等待。
四、持久化与恢复
AstraCache按照“先写数据、再提交位置”的顺序发布KV,发布后即可读取。同key写入冲突有明确的处理规则,提交幂等、可安全重试;元数据通过日志恢复,在途数据返回明确的重试状态。引擎重启、模型热更新或实例扩缩容后,已计算的前缀仍可继续复用,多轮对话也能跨天延续缓存。
五、同源底座
银河AstraCache与银河AIFS共享同一套代码底座,复用异步I/O、网络通信和存储管理能力。核心存储引擎已在银河 AI 存储的大量客户环境中得到验证,两条产品线的性能优化与功能演进相互促进。
典型场景
从已测试的客户情况看,以下几类负载的收益最直接。
知识库问答长文档RAG:每次请求携带相同的长文档前缀,命中缓存即可跳过对应的预填充计算。
多轮对话与智能客服:会话历史持续增长,相同前缀可跨请求、跨天复用。
Agent长上下文任务:Agent在多步任务中反复访问相同上下文,复用缓存可减少重复计算。
多租户推理平台:租户间共享相同的系统提示词和知识前缀,一次计算、全平台受益。
PD分离集群:预填充节点产生的KV通过共享存储交给生成节点,实现计算结果复用。
生态接入
银河AstraCache提供三条主流接入路径:vLLM原生KV Cache offloading、LMCache 存储插件,以及SGLang HiCache存储后端。推理引擎与缓存框架负责缓存调度和复用,银河AstraCache提供高性能共享存储。Mooncake接入也在持续推进。
“长上下文和多实例部署,让AstraCache从单机资源变成需要统一管理和共享的基础设施。银河AstraCache让已经完成的计算得到更多复用,帮助客户把GPU算力用于新的推理任务。”——霄云科技产品负责人